Enterprise архитектура
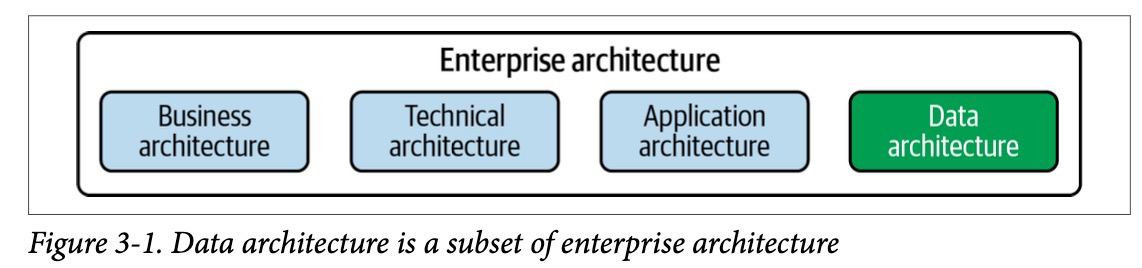
Enterprise архитектура включает подмножество архитектур, таких как бизнес-архитектура, техническая, архитектура приложения и архитектура данных.
Enterprise архитектура — это проектирование систем для поддержки изменений в организации, достигаемое за счет гибких и обратимых решений, принятых на основе тщательной оценки компромиссов.
Гибкие и обратимые решения необходимы по двум причинам. Во-первых, мир постоянно меняется, и предсказать будущее невозможно. Обратимые решения позволяют корректировать курс по мере изменений в мире и получения новой информации. Во-вторых, существует естественная тенденция к утрате гибкости организации по мере ее роста. Принятие культуры обратимых решений помогает преодолеть эту тенденцию, снижая риски, связанные с принятием решений.
Джеффу Безосу приписывают идею «дверей в один и два конца». Дверь в один конец — это решение, которое почти невозможно отменить. Например, Amazon мог бы продать AWS или закрыть его. После такого шага восстановить облачный сервис с той же рыночной позицией было бы практически невозможно. С другой стороны, дверь в два конца — это легко обратимое решение: можно войти, оценить ситуацию и либо продолжить движение вперед, либо вернуться обратно, если результат не устраивает.
Управление изменениями тесно связано с обратимыми решениями и является центральной темой в рамках архитектуры компании. Даже при акценте на обратимые решения организации часто вынуждены реализовывать крупные инициативы. В идеале их следует разбивать на более мелкие изменения, каждое из которых само по себе является обратимым решением.
Архитекторы выявляют проблемы в текущем состоянии (низкое качество данных, ограничения масштабируемости), определяют желаемые будущие состояния (гибкое улучшение качества данных, масштабируемые облачные решения, оптимизированные бизнес-процессы) и реализуют инициативы через выполнение небольших, конкретных шагов.
Важно подчеркнуть, что технические решения должны поддерживать бизнес-цели, а архитектура организации должна балансировать между гибкостью и необходимыми компромиссами для достижения оптимальных результатов.
Архитектура данных
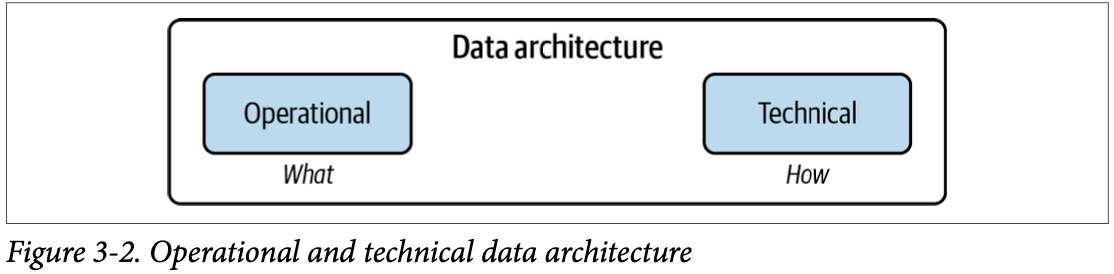
Архитектура данных — это проектирование систем для поддержки изменяющихся потребностей организации в данных, достигаемое за счет гибких и обратимых решений, принятых на основе тщательной оценки компромиссов.
Операционная архитектура охватывает функциональные требования к тому, что должно происходить в отношении людей, процессов и технологий.
Техническая архитектура определяет, как данные загружаются, хранятся, преобразуются и предоставляются на протяжении жизненного цикла работы с данными.
«Хорошая» архитектура данных
Хорошая архитектура данных обслуживает бизнес-требования с помощью общего, широко переиспользуемого набора строительных блоков, сохраняя гибкость и находя правильные компромиссы. Плохая архитектура авторитарна и пытается втиснуть множество универсальных решений в хаотичную и неуправляемую систему.
Гибкость — основа хорошей архитектуры данных, поскольку благодаря ей мы можем быстро адаптироваться в вечно меняющейся окружающей среде. Хорошая архитектура данных остается адаптивной и легко поддерживаемой. Она развивается в ответ на изменения в бизнесе, а также на появление новых технологий и практик, которые могут открыть ещё большую ценность для бизнеса в будущем.
Плохая архитектура данных отличается сильной связностью, жёсткостью, чрезмерной централизацией или использованием неподходящих инструментов, что затрудняет разработку и управление изменениями.
Принципы хорошей архитектуры данных
Фреймворк AWS Well-Architected состоит из шести ключевых принципов:
— Операционное совершенство
— Безопасность
— Надёжность
— Эффективность производительности
— Оптимизация затрат
— Устойчивость
Пять принципов облачно-нативной архитектуры Google Cloud:
— Проектируйте для автоматизации.
— Грамотно управляйте состоянием.
— Отдавайте предпочтение управляемым сервисам.
— Применяйте многоуровневую защиту.
— Постоянно улучшайте архитектуру
Мы хотели бы дополнить и расширить эти принципы, добавив ключевые принципы архитектуры инженерии данных:
— Осознанный выбор общих компонентов
— Планирование на случай отказов
— Проектируйте с учётом масштабируемости
— Архитектура — это лидерство
— Постоянно улучшайте архитектуру
— Стройте слабо связанные системы
— Принимайте обратимые решения
— Приоритизируйте безопасность
— Используйте принципы FinOps
Принцип 1: Осознанный выбор общих компонентов
Когда архитекторы принимают взвешенные решения и эффективно руководят, общие компоненты становятся основой для совместной работы команд и устранения изолированных процессов. Они способствуют гибкости внутри и между командами, объединяя общие знания и навыки. Общие компоненты могут включать любое широко применимое решение в организации, например:
— Объектное хранилище
— Системы контроля версий
— Инструменты наблюдаемости и мониторинга
— Системы оркестрации
— Движки обработки данных
Облачные платформы являются идеальной средой для внедрения таких компонентов.
Принцип 2: Планирование на случай отказов
Ключевые термины:
1) Доступность — процент времени, в течение которого ИТ-сервис или компонент находится в рабочем состоянии.
2) Надёжность — вероятность того, что система будет соответствовать установленным стандартам и выполнять свои функции в течение заданного интервала времени.
3) RTO (Recovery time objective, «целевое время восстановления») — максимально допустимое время простоя сервиса или системы. Например, один день простоя может быть допустимым для внутренней отчётности, но даже пять минут простоя могут серьёзно повлиять на бизнес интернет-ритейлера.
4) RPO (Recovery Point Objective, «цель точки восстановления») — максимально допустимый объём потерянных данных после сбоя. Время восстановления файлов из резервного хранилища не должно превышать RPO. Например, если RPO составляет 90 минут, то данные, накопленные за последние полтора часа, будут потеряны. Соответственно, снимок (snapshot) должен выполняться не реже одного раза в 90 минут. Резервное копирование может включать не только файлы на дисках, но и настройки приложений, параметры операционной системы сервера, а также состояние процессов в оперативной памяти.
Принцип 3: Проектирование с учётом масштабируемости
Масштабируемость в системах данных включает два ключевых аспекта:
- Система должна уметь масштабироваться вверх для обработки больших объёмов данных.
- Система должна масштабироваться вниз, автоматически снижая ресурсы после спада нагрузки для оптимизации затрат.
Идеальная система должна динамически адаптироваться к нагрузке в автоматическом режиме.
Принцип 4: Архитектура — это лидерство
Архитекторы данных несут ответственность за технологические решения, разработку архитектурных артефактов и распространение решений через лидерство и обучение.
Идеальный архитектор данных:
— Обладает техническими навыками инженера данных, но не занимается ежедневными инженерными задачами.
— Наставляет инженеров, консультируется с организацией при выборе технологий.
— Распространяет знания через обучение и управление процессами.
— Объединяет ресурсы компании для достижения общих целей в технологиях и бизнесе.
Принцип 5: Постоянно улучшайте архитектуру
Работа архитектора включает три основные задачи:
— Глубокое понимание текущей архитектуры.
— Разработка целевой архитектуры.
— Создание плана перехода с приоритизацией изменений
Принцип 6: Построение слабо связанных систем
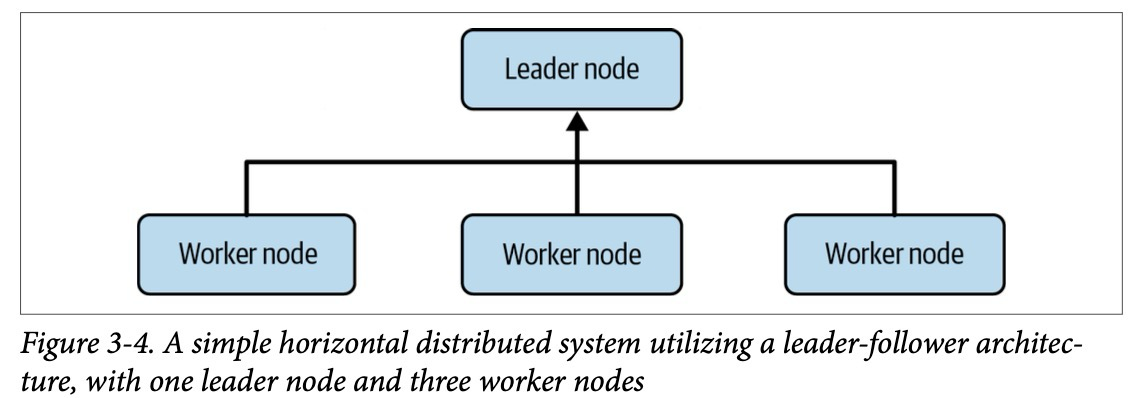
Системы должны быть спроектированы так, чтобы команды могли тестировать, развертывать и изменять их без зависимости от других команд. Это снижает необходимость в сложной коммуникации.
Признаки слабо связанных систем:
- Разделение на множество небольших компонентов.
- Взаимодействие между сервисами через уровни абстракции (например, API или шину сообщений), скрывающие внутренние детали.
- Изменения в одном компоненте не требуют изменений в других.
- Отсутствие глобального цикла релизов — каждый компонент обновляется независимо.
Принцип 7: Принятие обратимых решений
В условиях быстрой эволюции технологий и модульной архитектуры всегда выбирайте лучшие решения на текущий момент, но будьте готовы адаптироваться по мере появления новых решений.
Принцип 8: Приоритизация безопасности
Каждый инженер данных должен нести ответственность за безопасность создаваемых и поддерживаемых систем. Два ключевых подхода:
— Модель нулевого доверия (Zero Trust) — проверка и защита на всех уровнях доступа.
— Модель разделённой ответственности — распределение обязанностей между облачным провайдером и пользователями.
Принцип 9: Применение FinOps
FinOps — это подход к финансовому управлению облачными затратами, объединяющий инженеров, финансы и бизнес для принятия решений на основе данных.
Ранее инженеры данных ориентировались на производительность: максимизация скорости обработки на фиксированном количестве ресурсов.
С появлением FinOps важно учитывать и стоимость:
— Какой баланс между AWS Spot Instance при запуске распределённого кластера?
— Какая модель расчёта (pay-per-query vs. reserved capacity) будет выгоднее в долгосрочной перспективе
— Как достичь оптимального соотношения между стоимостью и производительностью при выполнении больших задач?
Основные архитектурные концепции
Домен и сервисы
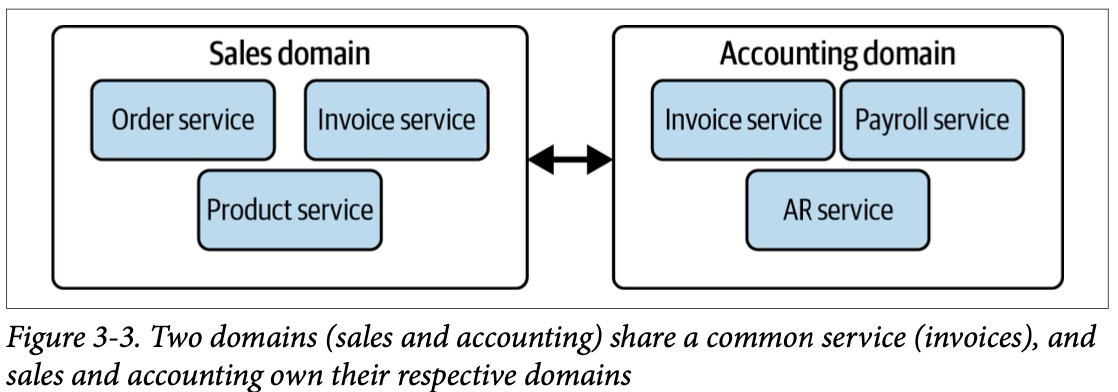
Домен — это предметная область реального мира, для которой создаётся архитектура. Сервис — это набор функций, предназначенных для выполнения определённой задачи. Один домен может включать несколько сервисов. Например, в домене продаж могут быть три сервиса: заказы, выставление счетов и товары. Каждый из них выполняет определённые задачи, поддерживающие общий процесс продаж.
При определении границ домена сосредоточьтесь на том, что он представляет в реальном мире.
Распределенные системы, масштабируемость, проектирование случаев отказа
Мы как инженеры данных рассматриваем четыре тесно связанных характеристик систем обработки данных:
— Масштабируемость (Scalability) — возможность увеличивать ёмкость системы для повышения производительности и обработки возросшей нагрузки. Например, нам может потребоваться масштабировать систему, чтобы справляться с высоким количеством запросов или обрабатывать огромные объёмы данных.
— Эластичность (Elasticity) — способность масштабируемой системы динамически адаптироваться. Высокоэластичная система может автоматически увеличивать или уменьшать ресурсы в зависимости от текущей нагрузки. Масштабирование вверх критично при росте спроса, а масштабирование вниз помогает снизить затраты в облачной среде. Современные системы иногда могут масштабироваться до нуля, полностью отключаясь при отсутствии нагрузки.
— Доступность (Availability) — процент времени, в течение которого IT-сервис или компонент находится в работоспособном состоянии.
— Надёжность (Reliability) — вероятность того, что система выполнит свои функции в соответствии с заданными стандартами в течение определённого промежутка времени.
Распределённые системы широко используются в различных технологиях обработки данных, которые вы будете использовать в своей архитектуре. Почти каждое облачное хранилище данных или объектное хранилище содержит под капотом механизмы распределения.
Жёсткая vs. Слабая Связанность: Уровни, Монолиты и Микросервисы
На одном конце можно выбрать крайне централизованные зависимости и процессы, где каждая часть домена и сервиса критически зависит от всех остальных доменов и сервисов. Такой подход называется жёсткой (тесной) связанностью (tightly coupled).
На другом конце находятся децентрализованные домены и сервисы, которые не имеют строгих зависимостей друг от друга. Этот подход называется слабой (разряженной) связанностью (loosely coupled). В такой архитектуре независимые команды могут легко разрабатывать системы, но их данные могут оказаться несовместимыми или малополезными для коллег из других команд.
Уровни Архитектуры
При разработке архитектуры важно учитывать её уровни. Архитектура состоит из различных слоёв — данных, приложений, бизнес-логики, представления и необходимо понимать, как их разделять.
Жёсткая связанность между уровнями создаёт уязвимости, поэтому при проектировании следует стремиться к максимальной надёжности и гибкости за счёт правильной организации и разделения слоёв.
Одноуровневая (Single-Tier) Архитектура
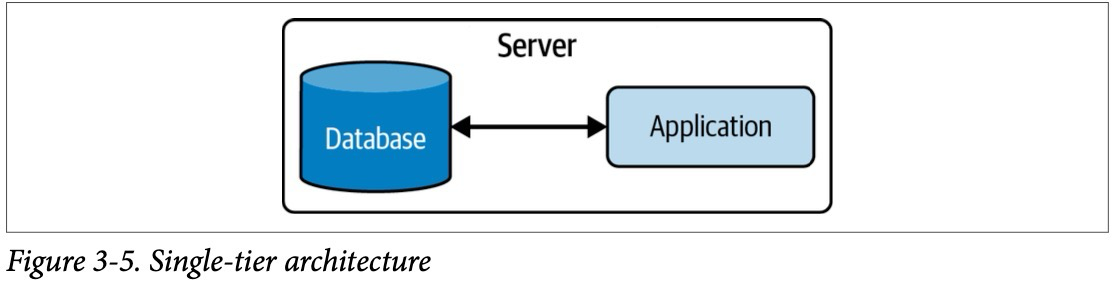
В одноуровневой архитектуре база данных и приложение тесно связаны и находятся на одном сервере.
Многоуровневая (Multitier, N-Tier) Архитектура
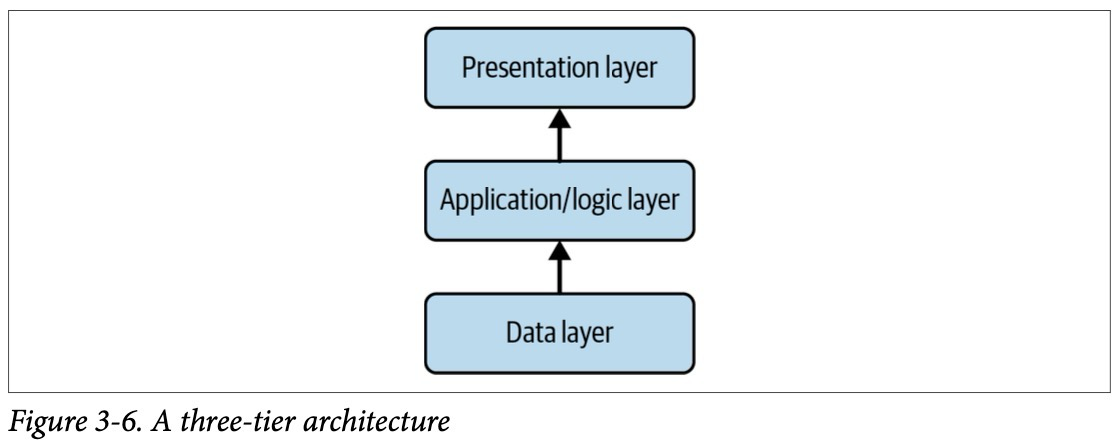
Многоуровневая архитектура (также известная как n-уровневая) состоит из отдельных слоёв: данных, приложения, бизнес-логики, представления и т. д. Эти слои организованы иерархически, то есть нижние слои не зависят от верхних, но верхние зависят от нижних.
Основная идея такой архитектуры — разделение данных, приложения и пользовательского интерфейса.
Один из самых распространённых видов многоуровневой архитектуры — трёхуровневая (three-tier) архитектура, которая используется в клиент-серверных системах. Она включает три уровня:
- Уровень данных (Data Tier) — хранение и управление данными.
- Уровень логики (Application Tier) — обработка данных и выполнение бизнес-логики.
- Уровень представления (Presentation Tier) — интерфейс пользователя, взаимодействие с системой.
Монолиты и Микросервисы
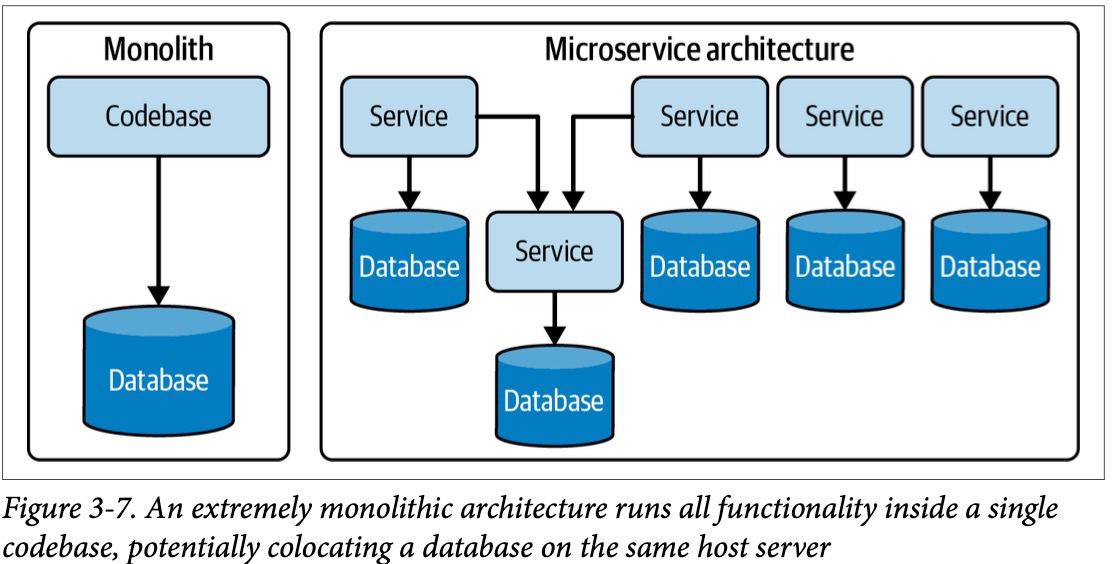
Монолиты (Monoliths)
Связанность внутри монолитных систем можно рассматривать с двух точек зрения:
- Техническая связанность (Technical Coupling) — относится к архитектурным уровням (tiers).
- Доменная связанность (Domain Coupling) — описывает, как домены взаимосвязаны друг с другом.
Монолитная архитектура может иметь различные степени связанности между технологиями и доменами. Например, приложение может быть организовано по многоуровневому (multitier) принципу, но при этом всё равно содержать жёстко связанные домены.
Микросервисы (Microservices)
Микросервисная архитектура состоит из раздельных, децентрализованных и слабо связанных сервисов.
— Каждый сервис выполняет конкретную функцию и не зависит от других сервисов в своём домене.
— Если один сервис временно выходит из строя, это не нарушает работу остальных сервисов.
— Такая архитектура обеспечивает гибкость, масштабируемость и отказоустойчивость по сравнению с монолитными системами.
Соображения по архитектуре данных
Вместо того чтобы слепо утверждать, что микросервисы лучше монолитов (и наоборот), лучше действовать исходя из практических соображений, стремиться к слабой связанности, учитывая ограничения технологий, используемых в вашей архитектуре данных.
Используйте обратимые технологические решения, которые позволяют создавать модульные и слабо связанные системы где это возможно.
Два подхода к управлению данными
- Централизация (Centralization)
— Одна команда отвечает за сбор данных из всех доменов, их согласование и подготовку для потребления всей организацией.
— Это традиционный подход, используемый в классических хранилищах данных (Data Warehouses).
- Data Mesh
— Каждая команда, занимающаяся разработкой ПО, самостоятельно подготавливает свои данные для использования в организации.
— Подход основан на децентрализации и позволяет лучше масштабировать архитектуру данных
Single vs Multitenant Access
В многоарендной (multitenant) архитектуре важно учитывать два ключевых аспекта: производительность и безопасность.
— Производительность: если несколько крупных арендаторов (tenants) используют облачную систему, сможет ли она обеспечивать стабильную работу для всех? Или возникнет проблема «шумного соседа», когда активное использование одним арендатором ухудшает производительность для других?
— Безопасность: данные различных арендаторов должны быть надёжно изолированы, чтобы исключить утечки или несанкционированный доступ.
Событийно-ориентированная архитектура (Event-Driven Architecture)
Бизнес-процессы редко бывают статичными: постоянно происходят события — например, регистрация нового клиента, оформление заказа или обновление статуса товара.
Событие (event) в этом контексте — это фиксирование изменения состояния чего-либо.
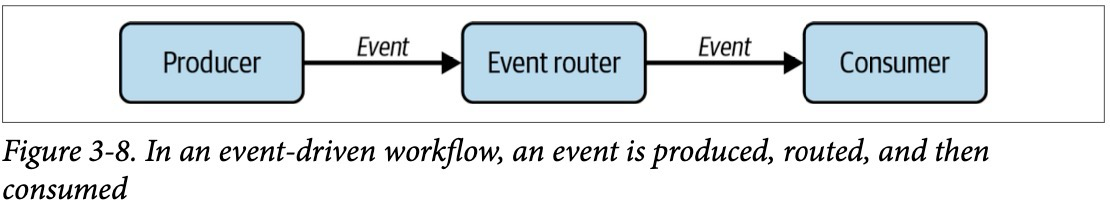
Событийно-ориентированный рабочий процесс (workflow) включает три ключевых этапа:
1. Создание событий (Event Production) — генерация событий системой.
2. Маршрутизация событий (Event Routing) — передача событий в нужные компоненты системы.
3. Потребление событий (Event Consumption) — обработка событий различными сервисами.
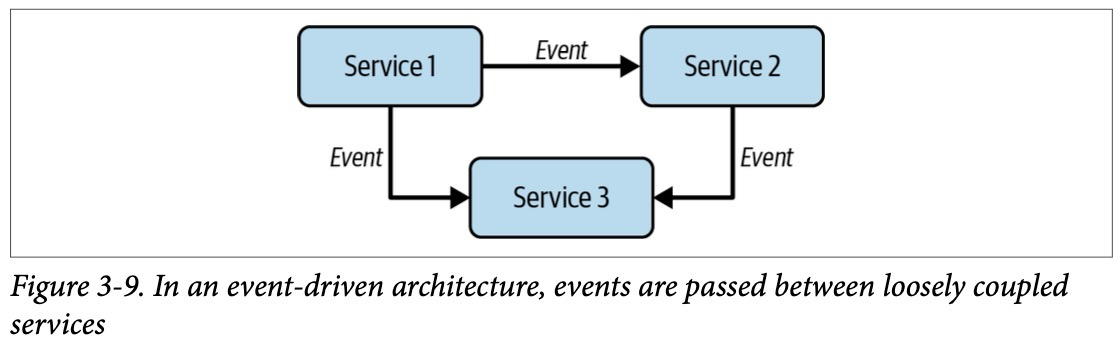
Событийно-ориентированная архитектура опирается на событийный workflow и использует его для связи между различными сервисами. Преимущество event-driven архитектуры заключается в том, что она распределяет состояние события между несколькими сервисами.
Brownfield vs. Greenfield проекты
Прежде чем приступить к разработке архитектуры данных, важно определить, начинаете ли вы с нуля или работаете с уже существующей системой.
Brownfield проекты
— Означают модернизацию или реорганизацию существующей архитектуры.
— Ограничены текущими и прошлогодними решениями, что создает дополнительные сложности.
— Требуют детального анализа наследованной системы и понимания, как старые и новые технологии взаимодействуют друг с другом.
— Часто связаны с рефакторингом, миграцией данных и постепенным улучшением архитектуры.
Greenfield проекты
— Начинаются с чистого листа, без ограничений прошлых решений.
— Позволяют выбрать наиболее современные и подходящие технологии.
— Чаще всего проще в реализации, так как отсутствуют технические долги.
— Дают архитекторам и инженерам больше творческой свободы и возможностей для инноваций.
Выбор между brownfield и greenfield подходом зависит от контекста: если модернизация невозможна или слишком затратна, может быть разумнее начать с нуля. Однако brownfield-проекты часто встречаются в крупных компаниях, где полное обновление инфраструктуры сразу невозможно.
Примеры типов архитектур данных
Поскольку архитектура данных — это достаточно абстрактная штука, проще всего ее понимать на конкретных примерах. В этом разделе мы рассмотрим популярные типы архитектур данных.
Data Warehouse (Хранилище данных)
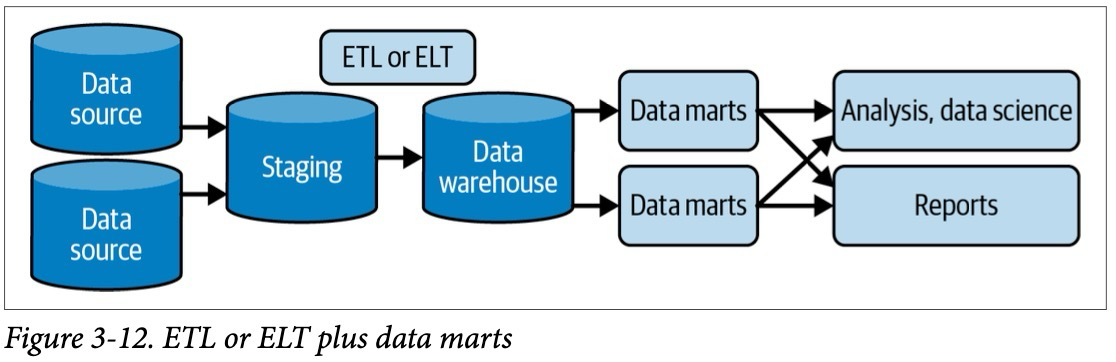
Data Warehouse (DWH) — это центральное хранилище данных, используемое для отчетности и аналитики. Данные в хранилище обычно тщательно структурированы и подготовлены для аналитических задач.
Существует два типа архитектуры хранилищ данных:
- Организационная архитектура DWH — ориентирована на структуру бизнеса, процессы и потребности различных команд.
- Техническая архитектура DWH — включает технические аспекты реализации, такие как архитектура MPP (Massively Parallel Processing), схемы хранения данных (звезда, снежинка) и механизмы ETL/ELT.
Организационная архитектура DWH обладает двумя ключевыми характеристиками:
- Разделение OLAP и OLTP
— OLAP (онлайн-аналитическая обработка) и OLTP (онлайн-операционная обработка) выполняют разные задачи.
— Важно отделять аналитическую нагрузку от транзакционных баз данных, чтобы избежать влияния аналитических запросов на производительность бизнес-приложений.
— DWH создается как отдельная физическая система, куда выгружаются данные, что повышает производительность аналитики и снижает нагрузку на продакшн-системы.
- Централизованная организация данных:
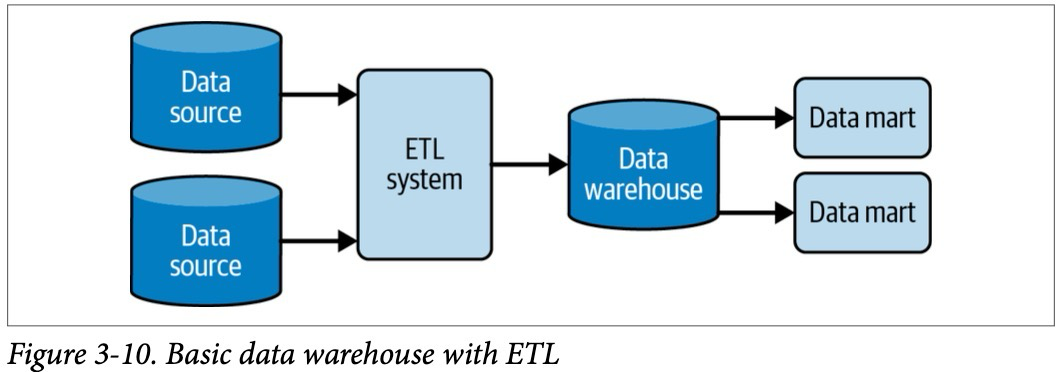
— Традиционно хранилище данных получает данные из различных систем через процессы ETL (Extract, Transform, Load).
— На этапе Extract данные извлекаются из источников (CRM, ERP, базы данных транзакций и др.).
— После этого они проходят обработку и загружаются в хранилище в структурированном виде, удобном для аналитических запросов.
ETL (Extract, Transform, Load) — традиционный подход, в котором данные:
- Extract — извлекаются из источников (базы данных, API, файлы).
- Transform — проходят преобразование (очистка, нормализация, агрегация) в промежуточной системе.
- Load — загружаются в хранилище данных в уже структурированном виде.
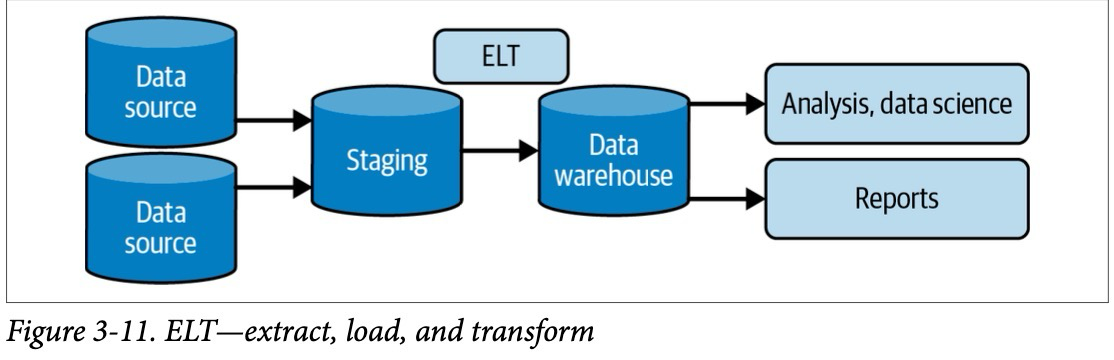
ELT (Extract, Load, Transform) — современный вариант, особенно популярный в облачных хранилищах:
- Extract — данные извлекаются из источников.
- Load — загружаются в хранилище в «сыром» виде без предварительной обработки.
- Transform — обработка и преобразование выполняются внутри хранилища с помощью его вычислительных мощностей (например, BigQuery, Snowflake, Redshift).
Cloud Data Warehouse (CDW)
Облачные хранилища данных (CDW) — это современный вариант традиционных on-premise хранилищ, обладающий рядом преимуществ:
— Горизонтальное масштабирование— ресурсы добавляются динамически.
— Гибкость и доступность — нет необходимости в сложной инфраструктуре.
— Оплата за использование — снижает издержки на поддержку серверов.
Популярные CDW-платформы:
— Amazon Redshift — первый облачный DWH, ориентирован на MPP (massively parallel processing).
— Google BigQuery — полностью управляемое хранилище с serverless-архитектурой.
— Snowflake — облачная DWH-платформа с разделением вычислительных и хранилищных ресурсов.
Data Mart
Data Mart — это тематическое подмножество данных из хранилища, предназначенное для конкретного отдела (маркетинг, финансы, продажи).
Причины использования Data Mart:
- Упрощенный доступ к данным — аналитики и бизнес-пользователи работают только с нужной информацией.
- Дополнительная трансформация — данные могут обрабатываться с учетом специфики подразделения.
- Производительность — уменьшение объема данных снижает нагрузку на запросы.
Data Marts могут строиться двумя основными способами:
— Independently — независимо от основного хранилища, получая данные напрямую из источников.
— Dependent — на основе центрального DWH, получая из него уже очищенные данные.
Связь CDW и Data Marts
Облачные хранилища часто используются как основа для Data Marts, обеспечивая быстрый доступ к агрегированным данным с учетом специфики различных бизнес-единиц.
Data Lake и его эволюция
Data Lake — это централизованное хранилище, в котором могут находиться данные в сыром виде без строгой схемы. Оно поддерживает все виды данных:
— Структурированные (таблицы, реляционные базы).
— Полуструктурированные (JSON, XML, Parquet).
— Неструктурированные (изображения, видео, логи, аудиофайлы)
Плюсы Data Lake:
— Гибкость: не требуется предварительное моделирование схемы.
— Масштабируемость: хранит огромные объемы данных в S3, HDFS
— Поддержка Machine Learning: данные можно использовать для анализа и моделей.
Однако со временем Data Lake стал превращаться в data swamp (болото данных), потому что:
— Данные плохо каталогизировались и терялись.
— Отсутствовала явная схема, что затрудняло анализ.
— Не было ACID-транзакций, сложно было обновлять данные.
Data Lakehouse — гибридное решение. Чтобы исправить недостатки Data Lake, появился Data Lakehouse, предложенный Databricks.
Особенности Data Lakehouse:
— ACID-транзакции (поддержка изменяемых данных, чего не было в классическом Data Lake).
— Схемы и индексация — можно добавлять структурированность, как в DWH.
— Отделение хранения и вычислений — данные хранятся в object storage, а обрабатываются SQL-движками (Spark, Trino).
— Универсальность — подходит и для аналитики, и для Data Science.
Modern Data Stack (MDS) — эволюция аналитической архитектуры
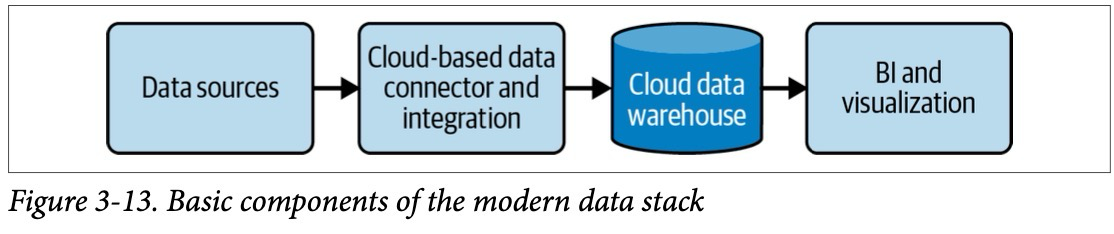
Modern Data Stack (MDS) — это современный подход к построению гибкой, масштабируемой и облачной аналитической платформы, который:
— Упрощает интеграцию данных.
— Использует облачные, plug-and-play сервисы вместо монолитных решений.
— Минимизирует затраты за счет pay-as-you-go.
— Автоматизирует процессы с минимальным кодом (low-code/no-code).
Если раньше стеки данных опирались на дорогие монолитные наборы инструментов, то основная цель современного стека данных — использовать облачные, готовые к подключению, простые в использовании и доступные компоненты для создания модульной и экономически эффективной архитектуры данных. Эти компоненты включают конвейеры данных, хранение, преобразование, управление и контроль данных, мониторинг, визуализацию и исследование данных.
Архитектура Lambda
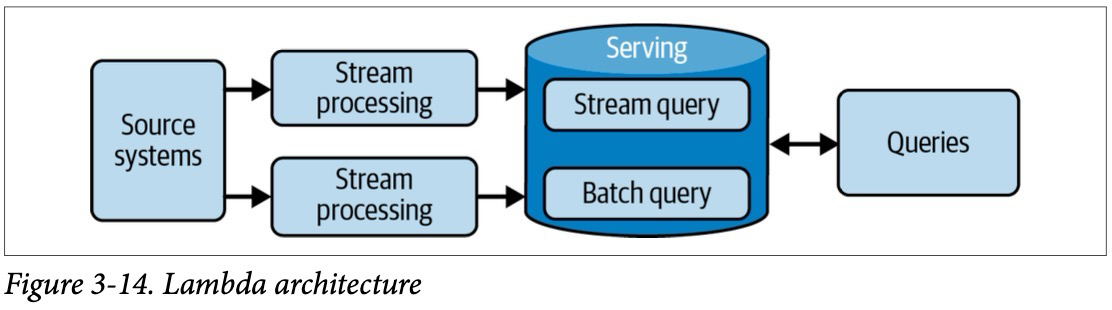
В архитектуре Lambda системы работают независимо друг от друга — пакетная обработка, потоковая обработка и слой обслуживания. Исходная система в идеале является неизменяемой и работает по принципу “только добавление”, отправляя данные в два направления для обработки: потоковую и пакетную.
Потоковая обработка предназначена для предоставления данных с минимальной задержкой, которая обычно реализуется на базе NoSQL-базы данных. В пакетном слое данные обрабатываются и трансформируются в таких системах, как хранилище данных, создавая предвычисленные и агрегированные представления данных.
Слой обслуживания объединяет результаты запросов из двух слоев, предоставляя целостный взгляд на данные.
Архитектура Kappa
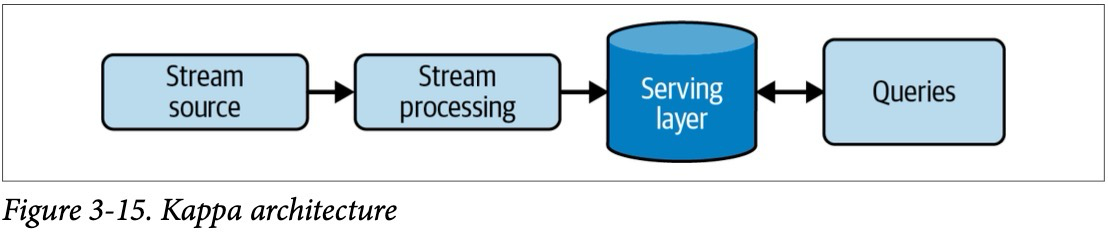
В качестве ответа на недостатки архитектуры Lambda Джей Крепс предложил альтернативу — архитектуру Kappa. Ее основная идея заключается в следующем: почему бы не использовать платформу потоковой обработки в качестве основы для всех этапов работы с данными — их получения, хранения и обслуживания?
Такой подход способствует созданию истинно событийной архитектуры. Потоковая и пакетная обработка могут применяться к одним и тем же данным без лишних сложностей: данные обрабатываются в реальном времени, а для пакетной обработки можно просто воспроизвести большие объемы событий из потока.
Хотя оригинальная статья об архитектуре Kappa была опубликована в 2014 году, ее широкого распространения пока не наблюдается. Возможно, этому есть несколько причин.
Во-первых, потоковая обработка по-прежнему остается чем-то загадочным для многих компаний: о ней легко говорить, но реализовать на практике сложнее, чем кажется. Во-вторых, архитектура Kappa на деле оказывается сложной и дорогостоящей в использовании.
Архитектура The Internet of Things (IoT)
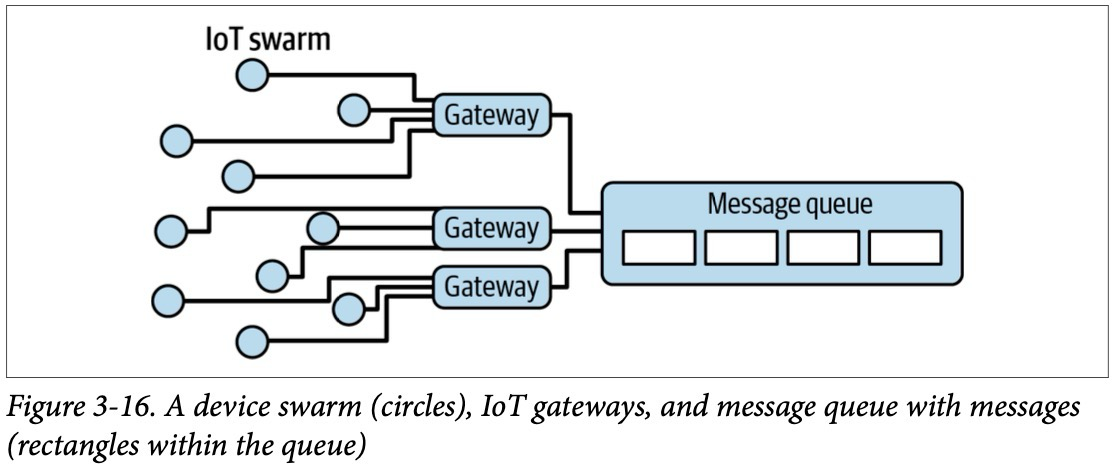
IoT — это распределенная сеть устройств: компьютеров, датчиков, мобильных устройств, умных гаджетов и любого другого оборудования, подключенного к интернету.
В отличие от данных, вводимых вручную человеком (например, с клавиатуры), данные в IoT генерируются устройствами, которые периодически или непрерывно собирают информацию из окружающей среды и передают ее в целевую систему.
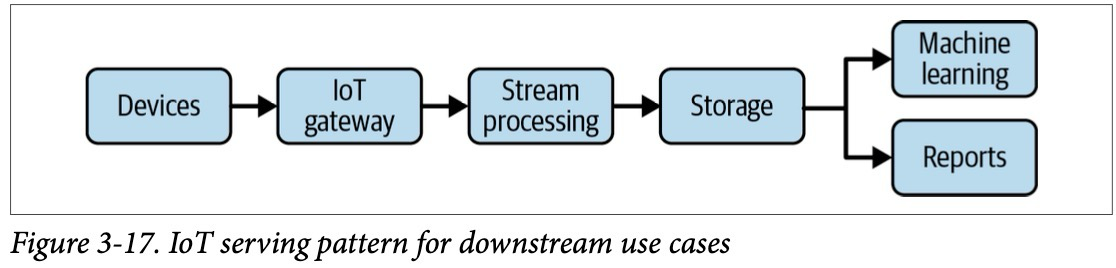
— Устройства — это физическое оборудование, подключенное к интернету, которое отслеживает окружающую среду, собирает данные и передает их в целевую систему.
— Взаимодействие с устройствами — IoT-шлюз выступает в роли узла для подключения устройств и безопасной передачи данных в нужные точки в интернете. Хотя можно подключить устройство напрямую, шлюз позволяет устройствам работать с минимальным энергопотреблением.
— Получение данных (Ingestion) — Процесс начинается с IoT-шлюза, как упомянуто ранее. Далее события и измерения поступают в архитектуру приема событий.
— Хранение — Требования к хранилищу зависят в значительной степени от допустимой задержки в системе IoT.
— Обслуживание (Serving) Способы обработки и представления данных сильно различаются. В пакетных приложениях данные могут анализироваться в облачном хранилище и предоставляться в виде отчетов.
Data Mesh
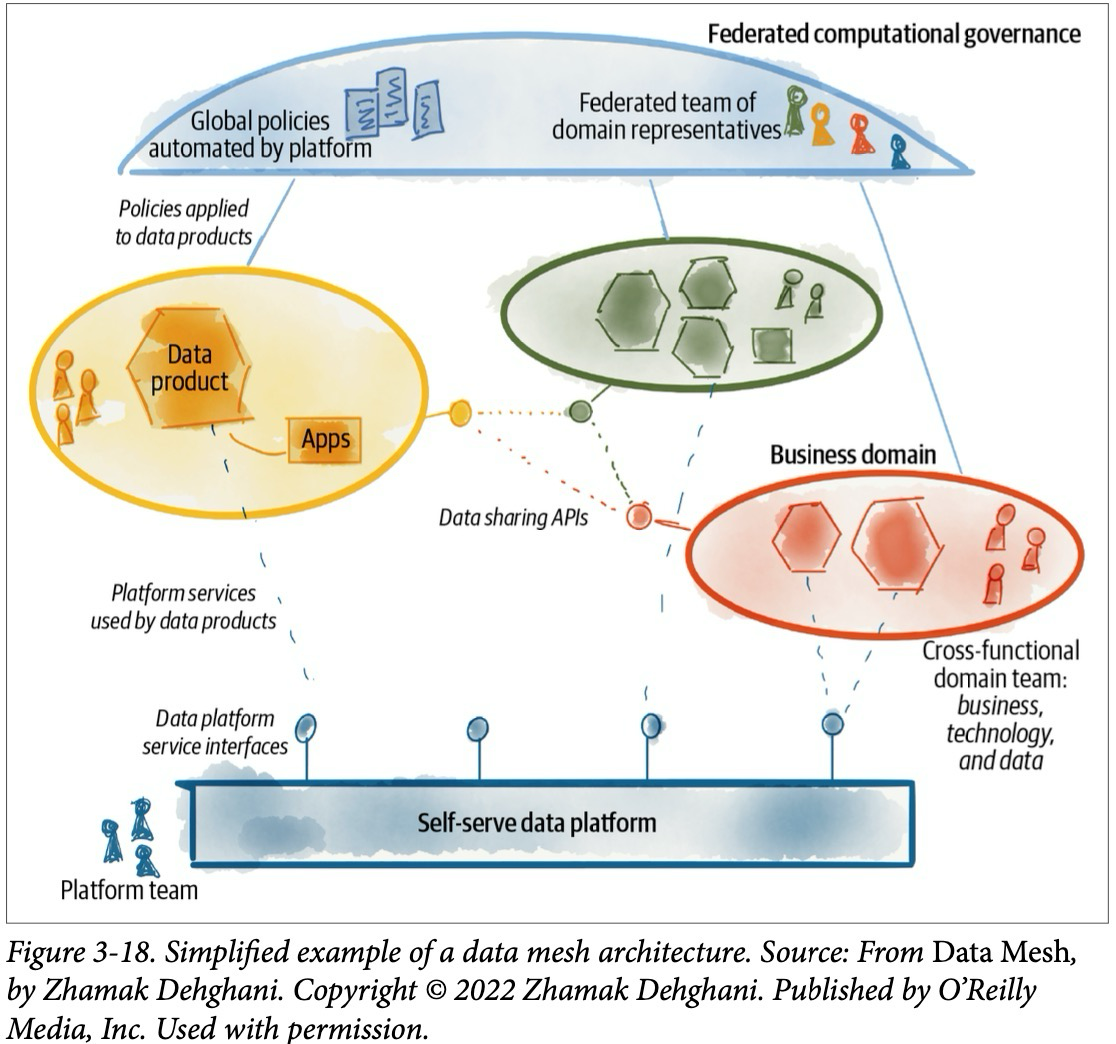
Data Mesh — это современный подход, предложенный в ответ на разрастающиеся монолитные платформы обработки данных, такие как централизованные озера данных и хранилища, а также на проблему разделения операционных и аналитических данных. Этот подход стремится переосмыслить традиционную централизованную архитектуру, применяя принципы предметно-ориентированного проектирования (Domain-Driven Design), широко используемые в разработке программного обеспечения, к архитектуре данных.
Чтобы избавиться от монолитной централизованной платформы, необходимо изменить подход к данным, их локальности и владению. Вместо того чтобы собирать данные из различных доменов в централизованное озеро данных или платформу, каждый домен должен самостоятельно управлять своими данными и предоставлять их в удобном для использования виде.
Джамак Дегхани выделила четыре ключевых принципа Data Mesh:
— Доменно-ориентированное децентрализованное владение данными и архитектура
— Данные как продукт
— Самообслуживаемая инфраструктура данных как платформа
— Федеративное вычислительное управление